AB 02 – Personen speichern und lesen
Die Situation
Das Grundgerüst steht. Jetzt soll es um die eigentliche Aufgabe gehen: Personen müssen dauerhaft gespeichert werden. Die Personalabteilung will neue Mitarbeiter anlegen und einzelne Datensätze wieder abrufen können.
Lernziele
Nach Bearbeitung dieses Arbeitsblatts kannst du:
- eine Klasse als JPA-Entität kennzeichnen und erklären, was Hibernate daraus macht
- ein Repository anlegen und begründen, warum du dafür keine Implementierung schreiben musst
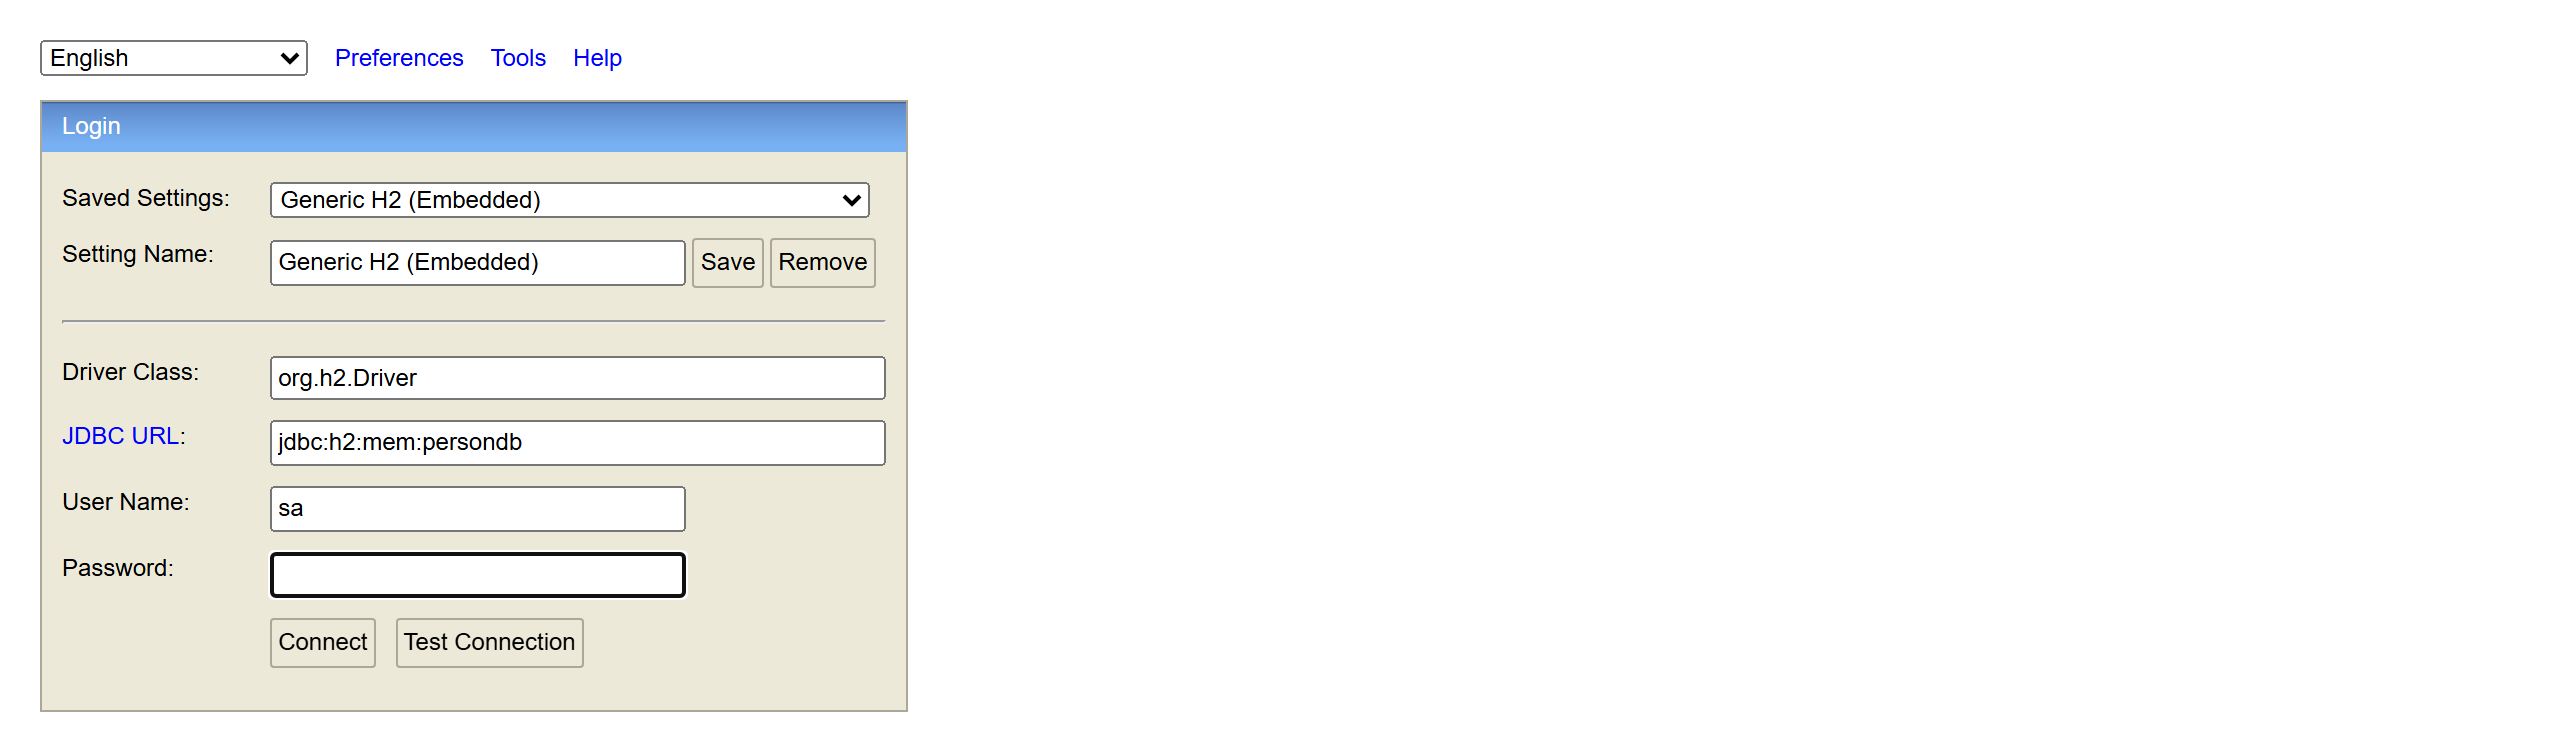
- eine H2-Datenbank konfigurieren und ihren Inhalt über die Web-Konsole prüfen
- einen
POST- und einenGET-Endpunkt implementieren - Konstruktor-Injektion anwenden und erklären, was Spring dabei tut
- passende HTTP-Statuscodes zurückgeben, auch im Fehlerfall
Die drei Schichten
Fast jede Backend-Anwendung ist in Schichten aufgebaut. Jede hat genau eine Aufgabe:
Im ersten Lehrjahr hast du im NHPlus-Projekt eine DAO-Klasse geschrieben — mit JDBC-Verbindung und selbst formulierten SQL-Anweisungen.
Das Repository ist dasselbe Konzept. Der Unterschied: Du schreibst es nicht mehr selbst.
Aufgaben
Aufgabe 1 – Die Datenbank konfigurieren
spring.application.name=personenverwaltung

# --- Datenbank ---
spring.datasource.url=jdbc:h2:mem:persondb
spring.datasource.username=sa
spring.datasource.password=

# --- H2-Console im Browser ---
spring.h2.console.enabled=true

# --- Hibernate ---
# Legt die Tabellen beim Start an und raeumt beim Beenden auf.
# Das ist auch die Voreinstellung fuer eine eingebettete Datenbank -
# hier steht sie ausdruecklich da, damit man sie spaeter aendern kann.
spring.jpa.hibernate.ddl-auto=create-drop
spring.jpa.show-sql=true
spring.jpa.properties.hibernate.format_sql=true
spring.jpa.open-in-view=false

# --- Fehlerantworten nach RFC 9457 ---
spring.mvc.problemdetails.enabled=true
server.error.include-stacktrace=never
Was die wichtigen Zeilen bewirken:
| Zeile | Bedeutung |
|---|---|
jdbc:h2:mem:persondb | H2 läuft im Hauptspeicher (mem). Die Daten sind nach dem Beenden weg. Für die Entwicklung ideal, weil nichts installiert werden muss. |
username=sa, password= | Zugangsdaten. Genau diese trägst du gleich in der H2-Console ein. |
spring.h2.console.enabled=true | Schaltet die Weboberfläche der Datenbank frei. |
ddl-auto=create-drop | Hibernate legt die Tabellen beim Start an und löscht sie beim Beenden. Für eine eingebettete Datenbank ist das ohnehin die Voreinstellung. |
spring.jpa.show-sql=true | Zeigt dir im Log, welches SQL Hibernate erzeugt. Sehr lehrreich. |
problemdetails.enabled=true | Fehler werden im Standardformat RFC 9457 zurückgegeben. |
include-stacktrace=never | Verhindert, dass interne Programmdetails nach außen gelangen. |
Die JDBC-URL, die du gleich in der Console eingibst, muss exakt mit der Zeile in dieser Datei übereinstimmen. Weicht sie ab, verbindet sich die Console mit einer anderen, leeren Datenbank — und du wunderst dich, wo deine Daten sind.
Aufgabe 2 – Die Entität Person
package de.szut.personenverwaltung.model;

import jakarta.persistence.Entity;
import jakarta.persistence.GeneratedValue;
import jakarta.persistence.GenerationType;
import jakarta.persistence.Id;

@Entity
public class Person {

    @Id
    @GeneratedValue(strategy = GenerationType.AUTO)
    private Long id;

    private String firstname;

    private String surname;

    public Person() {
    }

    // Getter und Setter für alle drei Attribute
    // (von der Entwicklungsumgebung erzeugen lassen)
}
Die Annotationen im Einzelnen:
| Annotation | Wirkung |
|---|---|
@Entity | Macht die Klasse zu einer JPA-Entität. Hibernate legt beim Start automatisch eine Tabelle PERSON an, jedes Attribut wird eine Spalte. |
@Id | Kennzeichnet das Attribut als Primärschlüssel. |
@GeneratedValue | Der Wert wird automatisch vergeben, nicht vom Programm gesetzt. Bei AUTO wählt Hibernate das Verfahren, das zur Datenbank passt. |
Hibernate erzeugt Objekte über den parameterlosen Konstruktor und füllt sie anschließend. Fehlt er, bekommst du beim Start eine schwer verständliche Fehlermeldung.
Genau deshalb kann eine Entität kein Record sein: Ein Record hat nur den Konstruktor mit allen Werten, seine Felder sind final, und Hibernate müsste nach dem Einfügen die erzeugte id nachträglich hineinschreiben — was bei final nicht geht.
Ausführlich steht das im Infoblatt JPA und Hibernate.
Aufgabe 3 – Das Repository
package de.szut.personenverwaltung.repository;

import de.szut.personenverwaltung.model.Person;
import org.springframework.data.jpa.repository.JpaRepository;

public interface PersonRepository extends JpaRepository<Person, Long> {
}
Das ist alles. Kein implements, keine SQL-Anweisung, keine Verbindungsverwaltung.
Die beiden Typparameter bedeuten:
Person— welcher Entitätstyp verwaltet wirdLong— welchen Datentyp der Primärschlüssel hat
Spring Data erzeugt sie beim Start zur Laufzeit. Es liest das Interface, erkennt den Entitätstyp und baut daraus eine vollständige Klasse mit allen CRUD-Methoden:
save() · findById() · findAll() · deleteById() · count() · existsById() …
Vergleiche das mit der DAO-Klasse aus dem ersten Lehrjahr. Dort hast du jede dieser Methoden von Hand geschrieben.
Aufgabe 4 – Der Controller mit POST und GET
package de.szut.personenverwaltung.controller;

import de.szut.personenverwaltung.model.Person;
import de.szut.personenverwaltung.repository.PersonRepository;
import org.springframework.http.HttpStatus;
import org.springframework.web.bind.annotation.*;
import org.springframework.web.server.ResponseStatusException;

@RestController
@RequestMapping("/api/v1/persons")
public class PersonController {

    private final PersonRepository repository;

    public PersonController(PersonRepository repository) {
        this.repository = repository;
    }

    @PostMapping
    @ResponseStatus(HttpStatus.CREATED)
    public Person createPerson(@RequestBody Person person) {
        return repository.save(person);
    }

    @GetMapping("/{id}")
    public Person getPersonById(@PathVariable Long id) {
        return repository.findById(id)
                .orElseThrow(() -> new ResponseStatusException(
                        HttpStatus.NOT_FOUND, "Keine Person mit der Id " + id));
    }
}
Woher kommt das Repository?
Der Controller braucht ein PersonRepository — erzeugt aber nirgends eines mit new. Stattdessen verlangt der Konstruktor eines.
Beim Start sucht Spring nach einer passenden Instanz und übergibt sie. Das nennt man Dependency Injection: Die Abhängigkeit wird von außen hineingereicht, statt dass die Klasse sie sich selbst beschafft.
Weil das Feld dadurch final sein kann — es ist nach dem Erzeugen garantiert gesetzt und kann nicht mehr verändert werden. Der Controller ist damit nie in einem halb fertigen Zustand.
Und es gibt einen zweiten Grund, der später wichtig wird: Man kann dem Konstruktor beim Testen ein Ersatzobjekt übergeben. Darauf kommen wir zurück.
Was die neuen Annotationen tun
| Annotation | Bedeutung |
|---|---|
@PostMapping | Beantwortet POST-Anfragen — hier zum Anlegen. |
@ResponseStatus(HttpStatus.CREATED) | Antwortet mit 201 statt mit 200. Das ist der richtige Code nach einem Anlegen. |
@RequestBody | Der JSON-Rumpf der Anfrage wird in ein Person-Objekt umgewandelt (Deserialisierung). |
@GetMapping("/{id}") | Ergänzt den Klassenpfad um einen variablen Teil: /api/v1/persons/1 |
@PathVariable | Bindet den variablen Teil der URL an den Methodenparameter. |
@PostMapping ist die Kurzform von @RequestMapping(method = RequestMethod.POST). Dasselbe gilt für @GetMapping, @PutMapping und @DeleteMapping.
Früher gab es nur die Langform, und man gab zusätzlich an, welche Datenformate der Endpunkt annimmt und liefert:
@RequestMapping(method = RequestMethod.POST,
                consumes = MediaType.APPLICATION_JSON_VALUE,
                produces = MediaType.APPLICATION_JSON_VALUE)
Beides ist heute überflüssig, weil JSON das Standardformat von Spring-REST-Endpunkten ist. Nötig wird es erst, wenn ein Endpunkt mehrere Formate bedienen soll — siehe HTTP kompakt.
Die Kurzform ist heute der Normalfall. Die Langform solltest du aber wiedererkennen, wenn du in einem Betrieb auf älteren Code stößt.
Was dabei mit den Daten passiert
Zwischen der Außenwelt und deiner Anwendung verläuft eine Grenze. Draußen gibt es nur Text — JSON ist eine Zeichenkette. Drinnen gibt es nur Java-Objekte. Bei jeder Überquerung muss umgewandelt werden.
In deiner Klasse steht id zuerst. In der Antwort erscheint es zwischen firstname und surname:
{
  "firstname": "Anna",
  "id": 1,
  "surname": "Schmidt"
}
Das ist kein Fehler. Ein JSON-Objekt ist laut Standard eine ungeordnete Menge von Paaren — welches Feld zuerst steht, hat keine Bedeutung. Die Bibliothek, die Spring zum Umwandeln benutzt, sortiert die Felder deshalb alphabetisch.
Merke dir daraus vor allem eines: Verlass dich in einem Client niemals auf die Reihenfolge der Felder. Gesucht wird über den Namen, nie über die Position.
Die Zahl der Überquerungen steht in der Methodensignatur:
public Person createPerson(@RequestBody Person person)
//     ──────              ────────────────────────────
//     hinaus              herein

public Person getPersonById(@PathVariable Long id)
//     ──────               ─────────────────────
//     hinaus               nur eine Zahl aus der URL, kein JSON
Ein Endpunkt mit @RequestBody nimmt JSON entgegen, einer ohne nicht. Beide geben JSON zurück, sobald sie ein Objekt zurückliefern.
orElseThrow statt isPresent und getfindById() liefert kein Person-Objekt, sondern ein Optional<Person> — einen Behälter, der ein Objekt enthalten kann oder eben nicht.
Man könnte mit isPresent() prüfen und mit get() herausholen. Kürzer und sicherer ist orElseThrow(): Ist etwas drin, wird es zurückgegeben — sonst wird die angegebene Ausnahme geworfen. Und daraus macht Spring die Antwort 404.
Aufgabe 5 – Personen anlegen und abrufen
Zum Testen brauchst du ein Werkzeug, das POST-Anfragen schicken kann — über die Adresszeile des Browsers geht nur GET.
IntelliJ legt die neue Datei dort an, wo im Projektbaum gerade etwas ausgewählt ist. Steht die Auswahl noch auf einer Klasse im Package controller, landet die Datei dort — und nicht neben der pom.xml.
Sollte dein Menü den Eintrag HTTP Request nicht anbieten, tut es auch eine gewöhnliche neue Datei mit dem Namen requests.http. Entscheidend ist die Endung; an ihr erkennt die Entwicklungsumgebung, was sie vor sich hat.
### Person anlegen
POST http://localhost:8080/api/v1/persons
Content-Type: application/json

{
  "firstname": "Anna",
  "surname": "Schmidt"
}

### Zweite Person anlegen
POST http://localhost:8080/api/v1/persons
Content-Type: application/json

{
  "firstname": "Ben",
  "surname": "Kaya"
}

### Person mit der Id 1 abrufen
GET http://localhost:8080/api/v1/persons/1

### Person abrufen, die es nicht gibt
GET http://localhost:8080/api/v1/persons/99
Beim POST schickst du kein id-Feld mit — in der Antwort ist eines enthalten. Die Datenbank hat es vergeben.
Der letzte Request liefert 404 und eine Fehlerantwort im Format RFC 9457:
{
  "type": "about:blank",
  "title": "Not Found",
  "status": 404,
  "detail": "Keine Person mit der Id 99",
  "instance": "/api/v1/persons/99"
}

Aufgabe 6 – In die Datenbank schauen
SELECT * FROM PERSON;
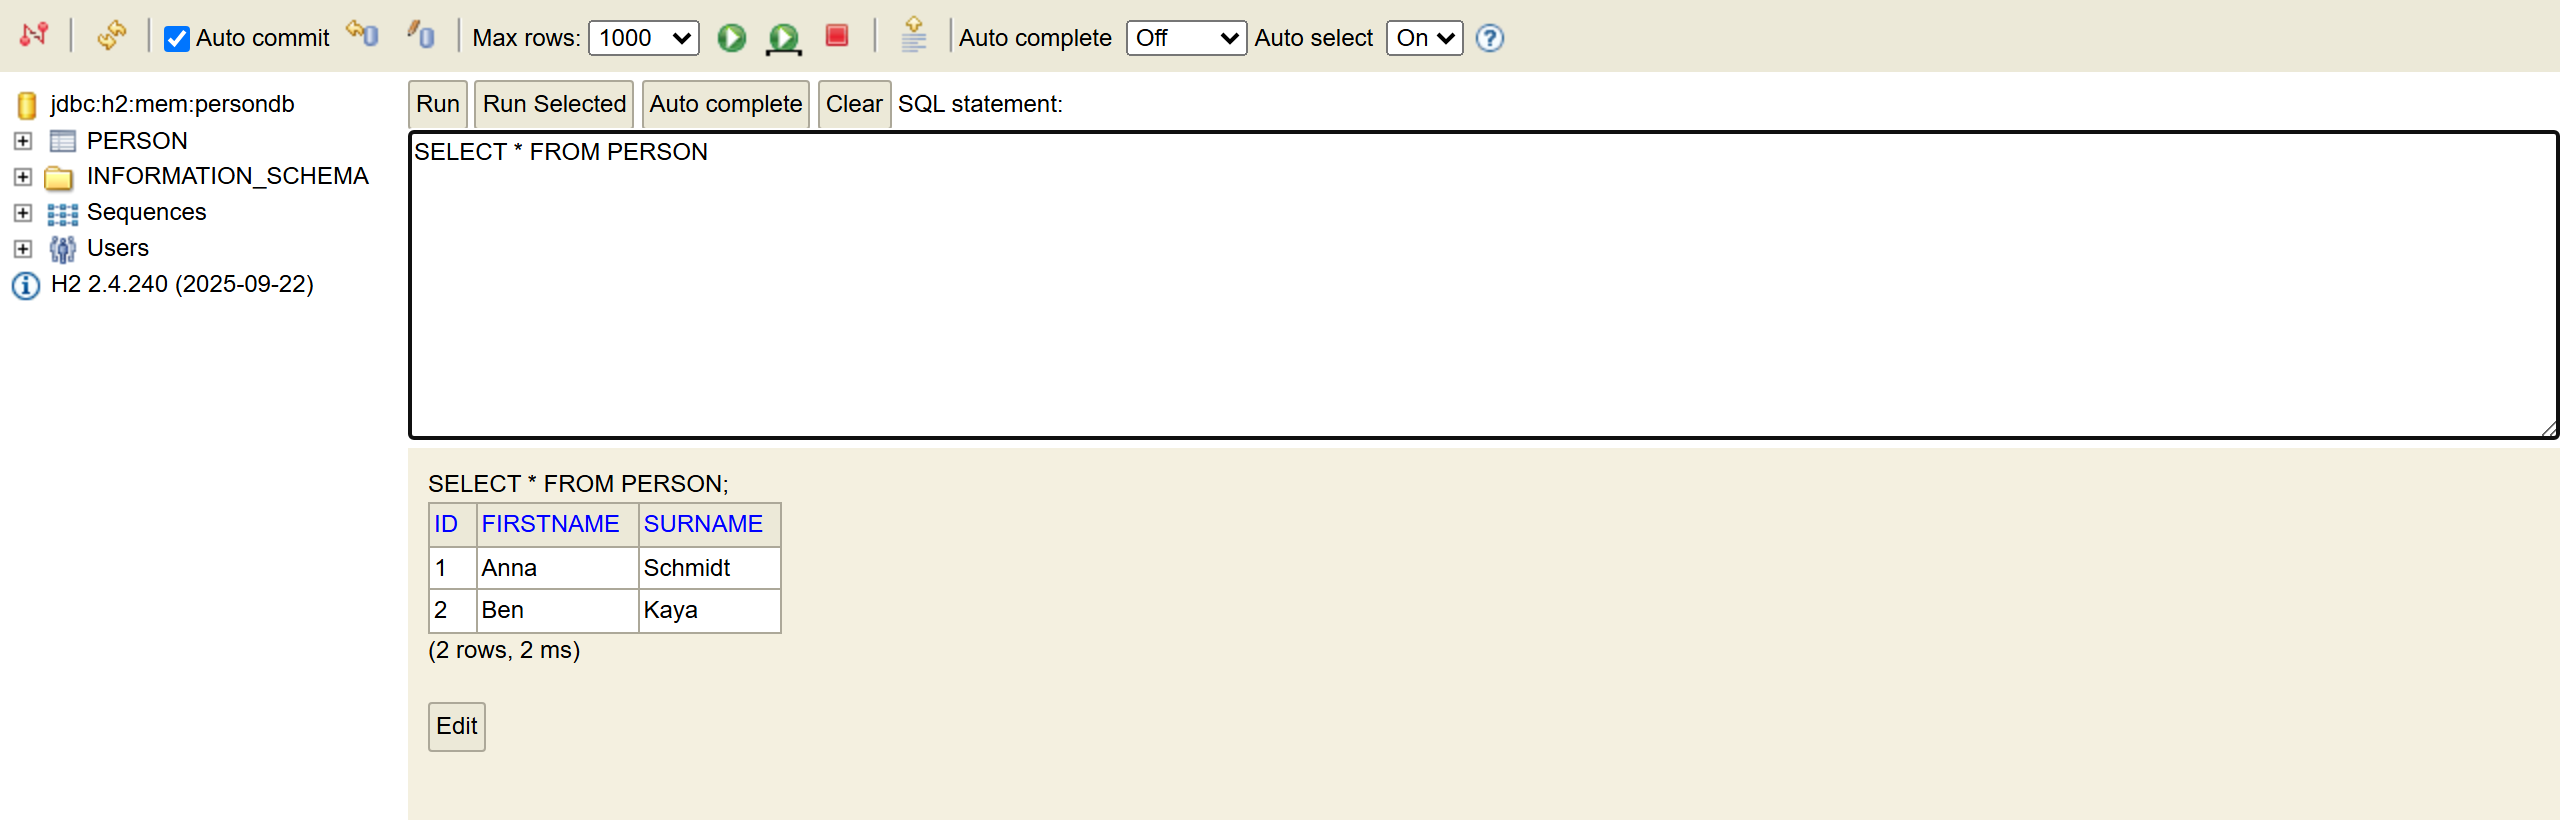
Du siehst dieselben Datensätze einmal als JSON über den Webservice und einmal als Tabelle über SQL.
Das ist der Kern des objektrelationalen Mappings: Hibernate übersetzt zwischen Java-Objekten und Datenbankzeilen. Du hast nie eine INSERT-Anweisung geschrieben — im Log kannst du nachlesen, dass Hibernate sie erzeugt hat.
Wie diese Übersetzung funktioniert und was JPA, Hibernate und Spring Data JPA jeweils dazu beitragen, erklärt das Infoblatt JPA und Hibernate.
Aufgabe 7 – Testfälle ausführen
| ID | Beschreibung | Vorbedingung | Testschritte | Erwartetes Ergebnis | Ergebnis |
|---|---|---|---|---|---|
| TF-01 | Tabelle wird beim Start angelegt | Anwendung wurde neu gestartet |
| Eine Anweisung create table person ist im Log zu finden. | |
| TF-02 | Person anlegen | Anwendung läuft, Datenbank ist leer |
| Status 201. Die Antwort enthält zusätzlich ein Feld id mit dem Wert 1. | |
| TF-03 | Zweite Person bekommt eine andere Id | TF-02 wurde ausgeführt |
| Status 201, id ist 2. | |
| TF-04 | Person per Id abrufen | TF-02 wurde ausgeführt |
| Status 200, Antwort enthält "firstname":"Anna". | |
| TF-05 | Unbekannte Id liefert 404 | Anwendung läuft |
| Status 404. Der Rumpf enthält "detail" mit der Meldung zur Id 99 — nicht Status 200 mit leerem Inhalt. | |
| TF-06 | Daten sind in der Datenbank angekommen | TF-02 und TF-03 wurden ausgeführt |
| Die Ergebnistabelle zeigt genau zwei Zeilen mit den Ids 1 und 2. | |
| TF-07 | Daten sind nach Neustart weg | TF-02 und TF-03 wurden ausgeführt |
| Status 404 — die In-Memory-Datenbank war leer beim Start. |
Dass die Daten nach einem Neustart verschwunden sind, ist gewollt: jdbc:h2:mem: bedeutet Hauptspeicher.
Im nächsten Tutorial stellst du auf eine dateibasierte Datenbank um und siehst den Unterschied.
Zusammenfassung
@Entitymacht aus einer Java-Klasse eine Datenbanktabelle;@Idund@GeneratedValueregeln den Primärschlüssel.- Ein Repository ist nur ein Interface — Spring Data erzeugt die Implementierung zur Laufzeit.
- Konstruktor-Injektion: Spring reicht benötigte Objekte von außen hinein; das Feld kann
finalsein. @RequestBodywandelt JSON in ein Java-Objekt, der Rückgabewert wird wieder zu JSON.201 Creatednach dem Anlegen,404 Not Foundbei unbekannter Id — nie200mit leerem Inhalt.- Eine Entität kann kein Record sein: Hibernate braucht den parameterlosen Konstruktor und veränderbare Felder.
Selbstkontrolle
- Was passiert beim Anwendungsstart mit einer Klasse, die
@Entityträgt? - Warum musst du
PersonRepositorynicht implementieren? - Was ist der Unterschied zwischen
@PathVariableund@RequestBody? - Warum liefert
findById()einOptionalund nicht direkt einPerson-Objekt? - Ein Kollege gibt bei unbekannter Id
200 OKmit dem Inhaltnullzurück. Nenne zwei Nachteile. - Nenne zwei Gründe, warum eine JPA-Entität kein Record sein kann.
Antworten
- Hibernate liest die Annotationen und erzeugt eine passende Tabelle. Jedes Attribut wird zu einer Spalte, das mit
@Idmarkierte zum Primärschlüssel. - Spring Data erzeugt die Implementierung zur Laufzeit aus dem Interface. Aus
JpaRepository<Person, Long>leitet es Entitätstyp und Schlüsseltyp ab und stellt alle CRUD-Methoden bereit. @PathVariablebindet einen Teil der URL an einen Parameter.@RequestBodywandelt den Rumpf der Anfrage in ein Java-Objekt um.- Weil es sein kann, dass zu der Id nichts existiert. Das
Optionalmacht diesen Fall sichtbar und zwingt den Aufrufer, ihn zu behandeln — statt stillschweigendnullzurückzugeben. - Erstens muss der Client den Rumpf auswerten, um überhaupt zu merken, dass etwas fehlt — der Statuscode allein sagt „alles in Ordnung". Zweitens lässt sich „nicht gefunden" nicht mehr von „gefunden, aber leer" unterscheiden.
- Erstens braucht Hibernate einen parameterlosen Konstruktor, den ein Record nicht hat. Zweitens sind die Felder eines Records
final— Hibernate muss aber die erzeugteidnachträglich setzen und Änderungen erkennen können.